Menu da documentação
Painel e análises
Runners gerenciados
Equipe e notificações
Faturamento e planos
Arquivos de workflow
Visão geral dos runners gerenciados
O que são os runners do Latchkey, os quatro tamanhos e seus preços, o que os torna diferentes dos runners hospedados pelo GitHub e o que você precisa antes do seu primeiro job.
- $0,0025
- por minuto preço inicial (small)
- ~2s
- captação a quente quando um runner a quente já está online
- 1
- job por runner destruído em seguida
- 58%
- mais barato no small, por minuto de runner, em relação ao GitHub
- 2.000+
- minutos gratuitos em equivalente small, mensalmente em todo plano
Resumo
- Quatro tamanhos:
latchkey-small(2 vCPU, $0,0025/min) atélatchkey-xlarge(16 vCPU, $0,0200/min), Ubuntu 24.04 x64. - Um job por runner, destruído em seguida; um runner a quente que já está online capta em cerca de dois segundos (Launch em diante).
- Todo plano inclui de 2.000 a 6.000 minutos gratuitos de runner em equivalente small por mês.
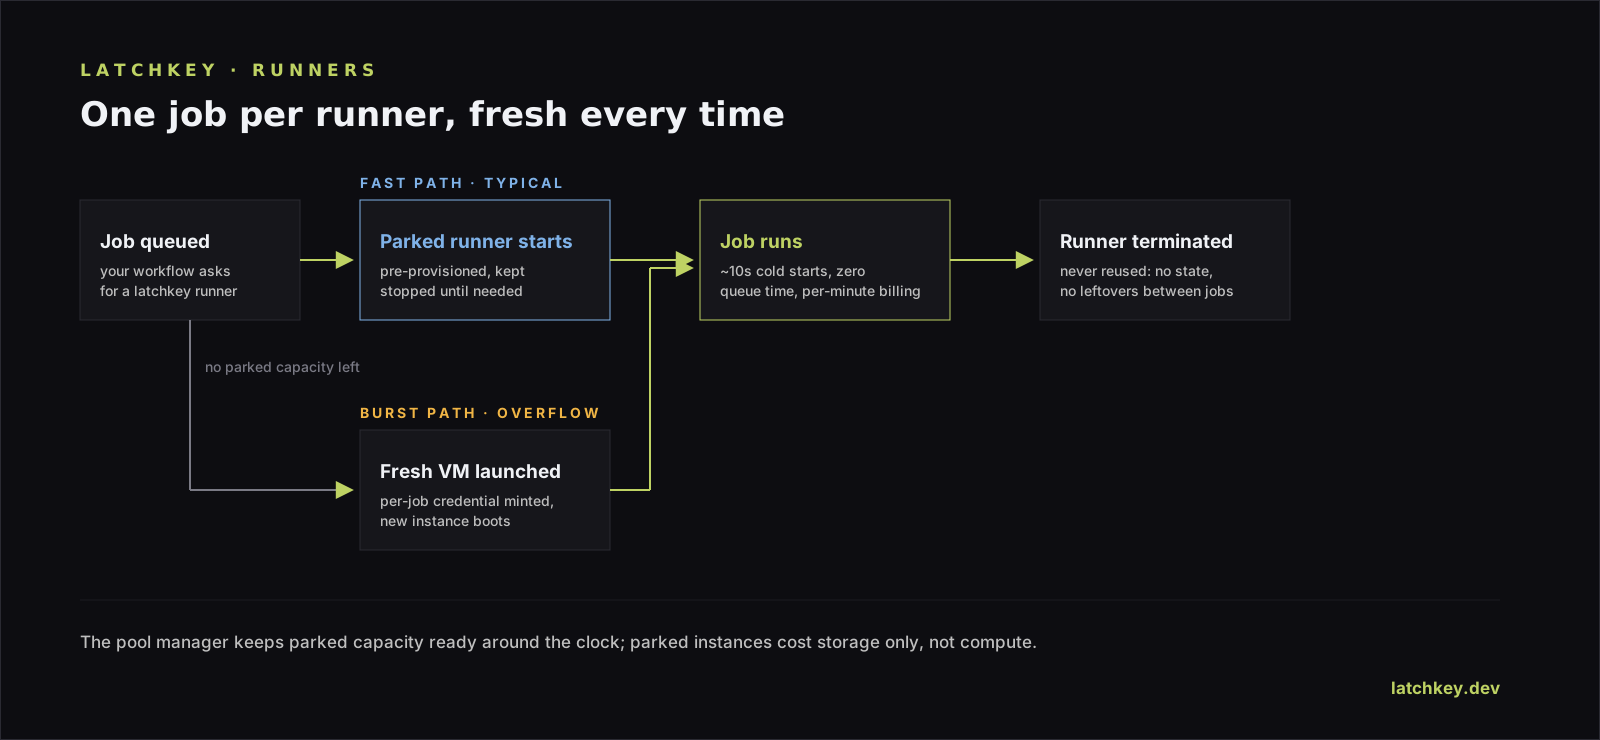
Os runners gerenciados do Latchkey são máquinas virtuais efêmeras que executam seus jobs do GitHub Actions. Cada runner executa exatamente um job e é destruído em seguida, então todo job começa em uma máquina limpa e isolada. Todo runner também vem com autorreparo integrado.
Tamanhos e preços#
| Rótulo | vCPU | Memória | Disco | Preço |
|---|---|---|---|---|
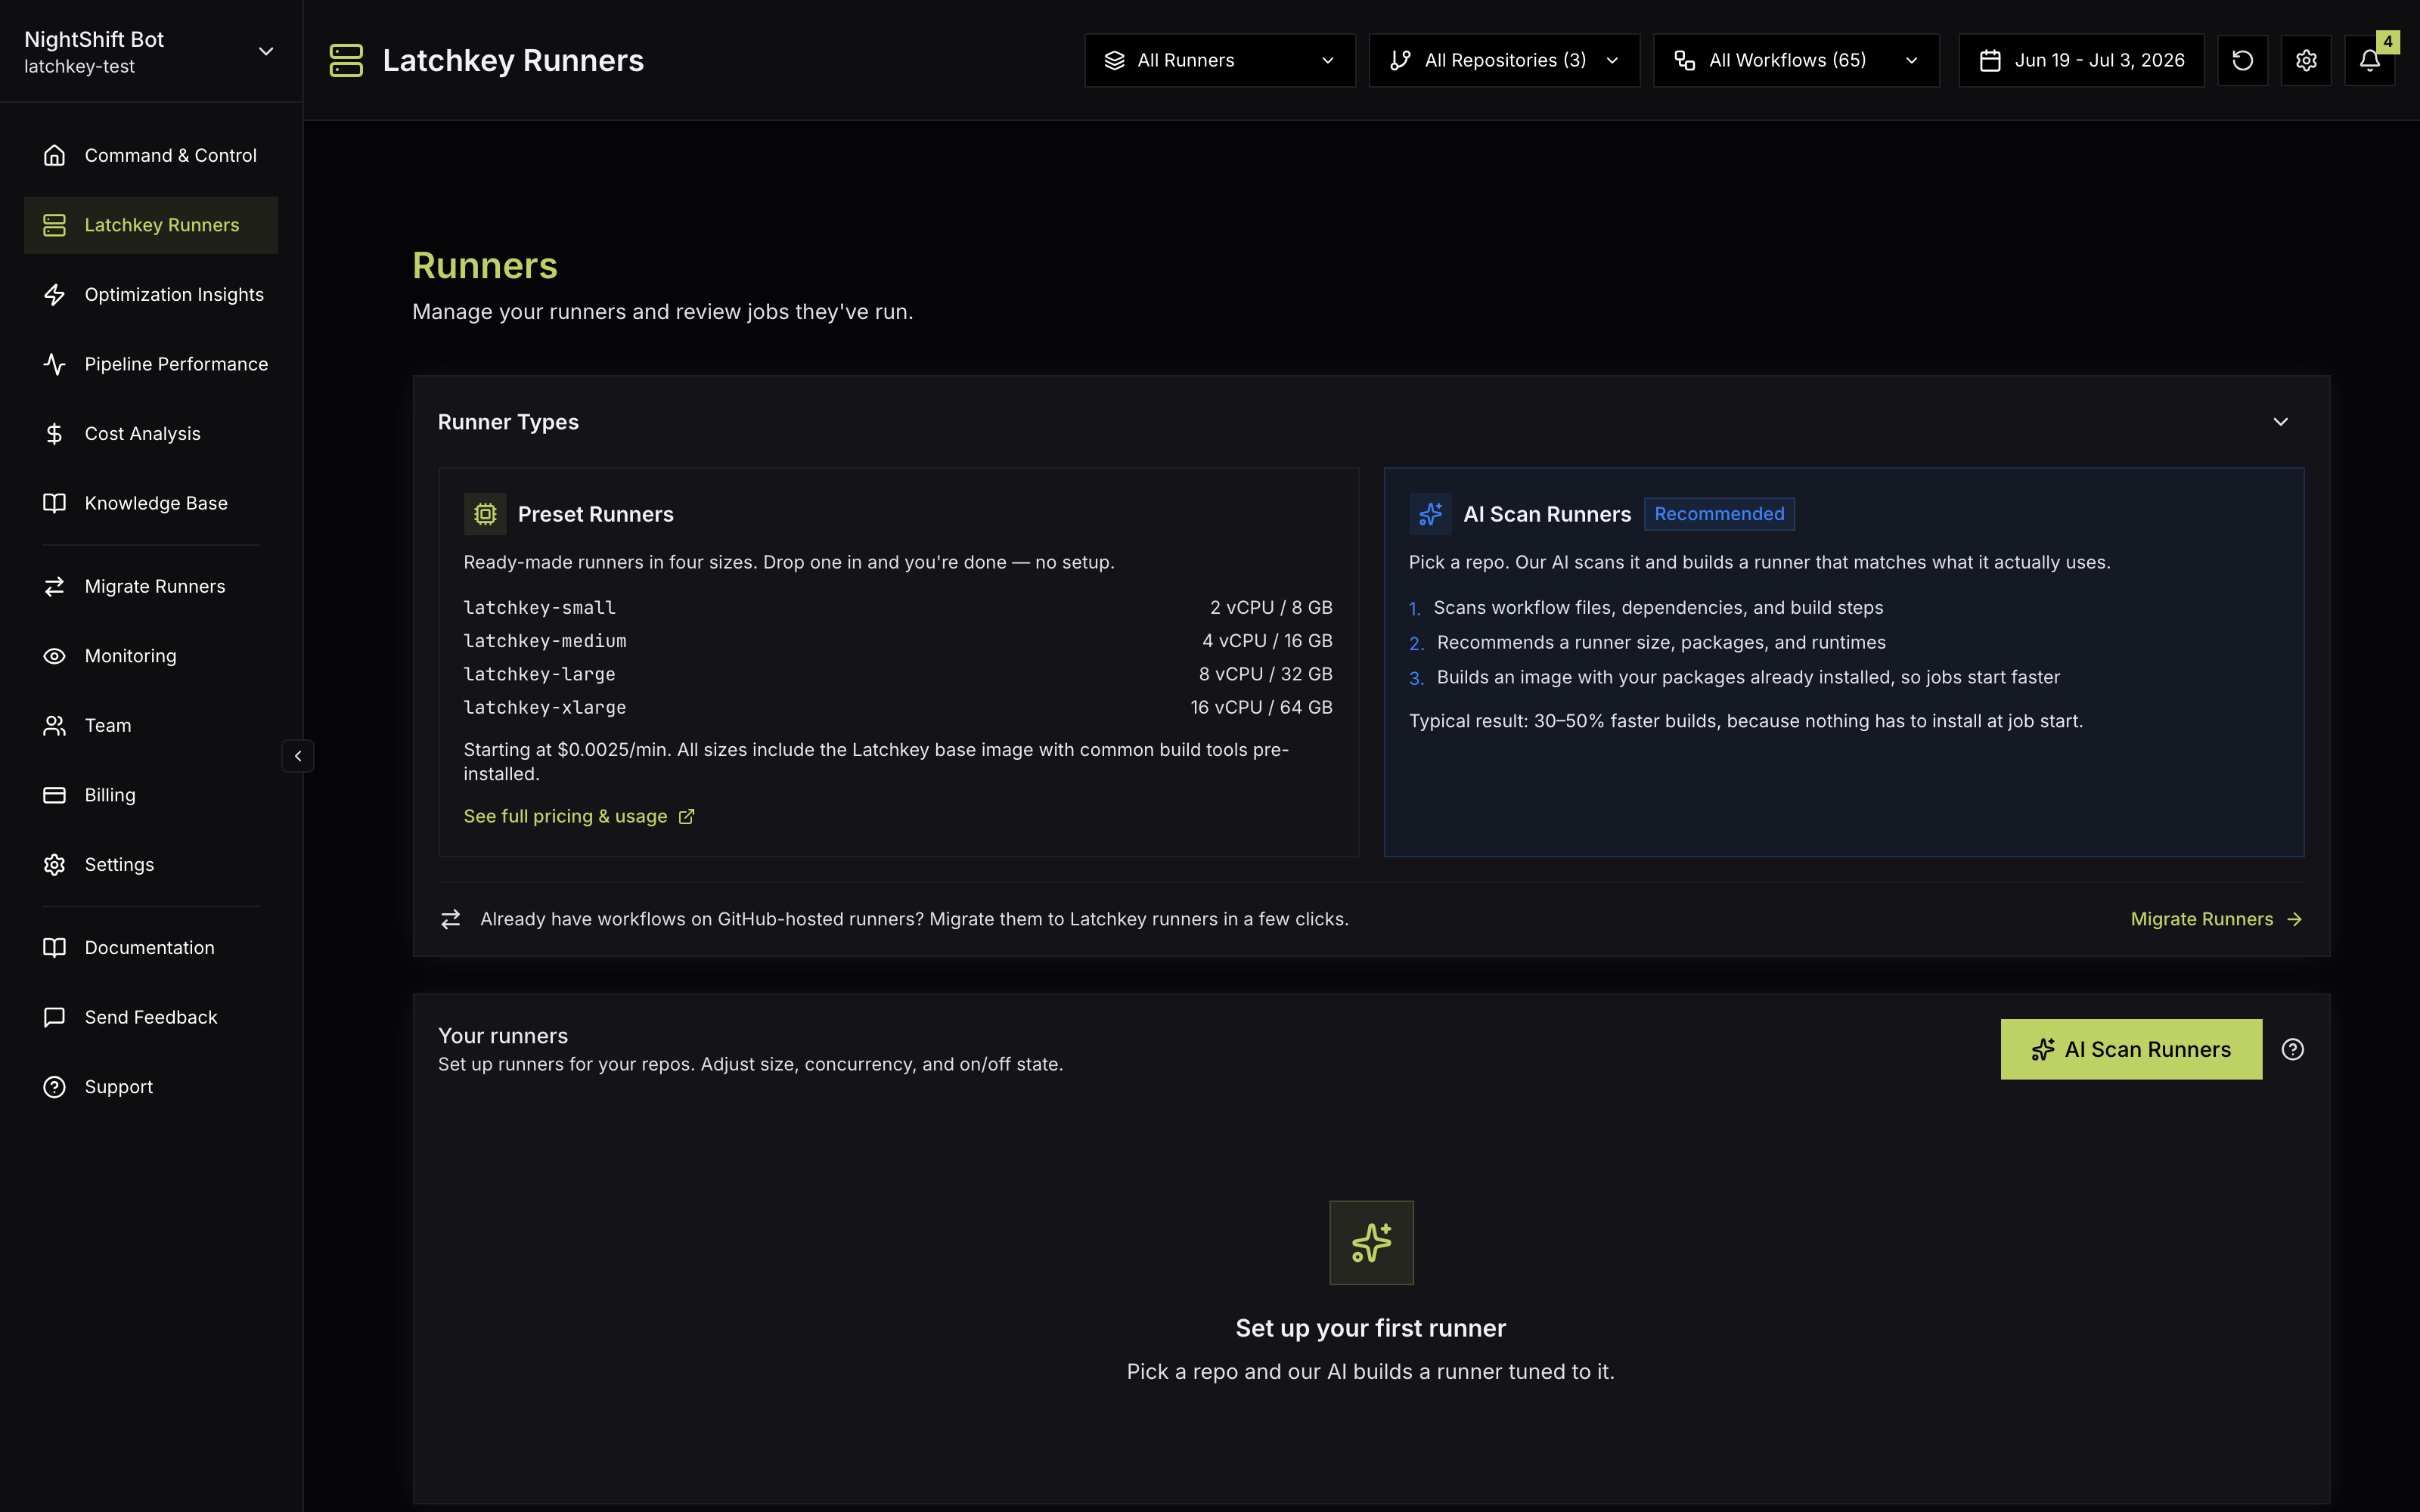
latchkey-small | 2 | 8 GB | 100 GB | $0,0025/min |
latchkey-medium | 4 | 16 GB | 100 GB | $0,0050/min |
latchkey-large | 8 | 32 GB | 100 GB | $0,0100/min |
latchkey-xlarge | 16 | 64 GB | 200 GB | $0,0200/min |
Todos os runners são Ubuntu 24.04 LTS em x86_64 (hardware da classe m6a da AWS) com uma cadeia de ferramentas pré-instalada e abrangente. A cobrança é por minuto, arredondada para cima por job, e todo plano inclui minutos gratuitos em equivalente small por mês (2.000 no Developer, 4.000 no Launch, 6.000 no Scale; ou seja, 4.000 por mês no nível intermediário, contra 3.000 no GitHub); veja Uso de runners e minutos gratuitos.
Qual tamanho você deve escolher?#
Trate o que segue como orientação, não como regra: os tempos de execução dos seus próprios jobs são o verdadeiro parâmetro. O padrão que atende à maioria das equipes é definir tudo como latchkey-small por padrão e depois promover os jobs específicos que comprovarem precisar de mais.
| Tamanho | Um bom primeiro encaixe para | Por quê |
|---|---|---|
latchkey-small | Lint, testes unitários, scripts, builds pequenos | A maioria dos jobs de CI é limitada por I/O ou por um único núcleo; 2 vCPU / 8 GB dão conta deles pela menor tarifa |
latchkey-medium | Suítes de teste típicas de aplicativos, builds de imagens Docker | Duas vezes a CPU e a memória do small, para runners de teste paralelos e builds de imagens multiestágio |
latchkey-large | Builds pesados de compilação, suítes de integração paralelas | 8 vCPU / 32 GB servem bem para trabalhos que escalam com núcleos: grandes builds em TypeScript, Rust, Java ou C++ |
latchkey-xlarge | Builds de monorepo, suítes end-to-end famintas por memória | 16 vCPU / 64 GB mais o disco de 200 GB, para os jobs mais pesados que, de outra forma, precisariam ser divididos |
Duas propriedades da linha facilitam raciocinar sobre o dimensionamento correto. Cada degrau acima dobra vCPU, memória e a tarifa por minuto, então promover um job de tamanho vale a pena quando ele pelo menos reduz pela metade a duração daquele job: mesmo custo ou menos, e feedback mais rápido. E o runs-on é escolhido por job, não por workflow, então um único job de build pesado no latchkey-large nunca força seu job de lint a sair do latchkey-small.
Por que as equipes mudam#
- Preço: de 52 a 58% menos por minuto de runner do que os runners hospedados pelo GitHub, com mais minutos gratuitos do que o GitHub inclui (4.000 contra 3.000 no nível intermediário).
- Velocidade: um runner a quente que já está online capta um job em cerca de dois segundos nos planos Launch e Scale.
- Autorreparo: falhas transitórias (timeouts de registry, kills por OOM, discos cheios, ferramentas ausentes) são detectadas e corrigidas durante a execução.
- Isolamento: um job por runner, em uma rede privada sem acesso de entrada, destruído após o job.
- Zero infraestrutura para gerenciar: nenhuma imagem de runner para construir, nenhum autoscaling para ajustar, nenhum agente de runner para atualizar.
Efêmero por design#
Todo runner é criado para um job e destruído no momento em que esse job termina. Nada persiste entre jobs: nenhum processo remanescente, nenhum cache obsoleto, nenhum arquivo que um job anterior tenha escrito em disco. Essa garantia de máquina limpa é o que torna as execuções reproduzíveis; se um job passa hoje e falha amanhã, a diferença está na sua alteração ou em uma dependência, não em estado acumulado em uma máquina de vida longa.
A mesma propriedade sustenta a história de segurança. Um runner se registra just-in-time com credenciais de uso único, roda em uma rede privada sem acesso de entrada, recebe exatamente um job e é destruído: não há janela para um job observar outro, e nenhuma máquina de vida longa para atualizar e blindar. Veja Segurança e permissões para o quadro completo.
Planeje-se em torno disso também: tudo que for escrito no disco local do runner some quando o job termina. Persista saídas de build como artefatos e acelere instalações com caches, exatamente como você faria em runners hospedados pelo GitHub.
Pré-requisitos#
- O GitHub App do Latchkey está instalado na sua organização.
- O repositório é monitorado no Latchkey.
- Os runners gerenciados estão habilitados para seu workspace (eles são configurados automaticamente quando o app é instalado; a página Runners no dashboard mostra sua prontidão e configurações).
- Sua assinatura ou trial está ativo. Lançamentos de runner são bloqueados para trials expirados e assinaturas vencidas; veja Uso de runners e minutos gratuitos.
Como funciona o provisionamento#
Quando o GitHub enfileira um job com um rótulo latchkey-*, o Latchkey ou o entrega a um runner já aquecido ou lança um novo:
Runner a quente já online
- Captação em cerca de dois segundos quando o runner já está online
- Launch e Scale incluem capacidade de pool a quente
Runner novo (início a frio)
- Uma nova máquina inicializa só para o seu job
- Registra-se just-in-time com credenciais de uso único
- Rodando assim que a máquina nova se registra
- Qualquer job além da linha de base a quente, ou que peça um tamanho maior, segue este caminho
De qualquer forma, o runner é destruído após seu job. O ciclo de vida completo, os pools a quente, a concorrência e por que um job pode esperar estão em Como funciona o provisionamento. Além dos quatro presets, você pode criar configurações de runner personalizadas com seus próprios rótulos, e a página de Runners no dashboard é onde você gerencia tudo isso.
Uma estratégia de migração que funciona#
Você não precisa de uma migração de uma só vez, e sugerimos evitá-la. Os rótulos hospedados pelo GitHub continuam funcionando lado a lado com os rótulos latchkey-*, então você pode mover um job de cada vez e comparar os dois diretamente nas suas próprias cargas de trabalho.
- 01Escolha um workflowComece por um instável ou lento, onde os ganhos são mais visíveis
- 02Acompanhe por uma semanaCompare duração, tempo de captação, custo e reparos na página de Runners
- 03Depois mude em massaUse a ferramenta Migrate Runners para trocar o restante da frota
Um workflow instável ou lento é o melhor piloto porque minutos mais baratos, captação mais rápida e autorreparo aparecem todos onde a dor já está. Após uma semana, a página de Runners lhe dá custo, economia e atividade de reparos para julgar; quando você estiver convencido, a ferramenta Migrate Runners na página de Runners (owners e admins) abre pull requests prontos para merge que trocam até 20 repositórios de uma vez; o passo a passo completo está em Migre dos runners hospedados pelo GitHub. Jobs que precisam de GPU, Windows, macOS ou hosts arm64 permanecem nos hospedados pelo GitHub ou outros runners, e misturar dentro de um único workflow é normal.
Decidindo entre provedores? A biblioteca Learn tem um hub de comparação de runners independente cobrindo hospedados pelo GitHub, Blacksmith, BuildJet e mais, além de uma calculadora de custos do GitHub Actions para estimar gastos com seus próprios números antes de trocar qualquer coisa.
Quais tamanhos de runner o Latchkey oferece?
Quatro, todos Ubuntu 24.04 x64: latchkey-small com 2 vCPU a $0,0025 por minuto, até latchkey-xlarge com 16 vCPU a $0,0200 por minuto. Todos os planos incluem de 2.000 a 6.000 minutos de runner gratuitos por mês, conforme o plano. Os minutos de runner gratuitos são contados em unidades equivalentes ao small: um minuto no latchkey-small conta como um, no medium como dois, no large como quatro e no xlarge ou em um runner personalizado como oito, e a franquia incluída em cada plano permanece a mesma.
Quão rápido um runner Latchkey inicia?
Um runner a quente que já está online capta um job em cerca de dois segundos, nos planos Launch e superiores. Um cold start leva mais tempo, porque uma máquina nova precisa inicializar e se registrar primeiro. Em ambos os casos o runner é uma máquina nova: um job por runner, destruída em seguida.
Como os runners Latchkey diferem dos hospedados no GitHub?
De duas formas que importam. A tarifa publicada é de $0,0025 por minuto para 2 vCPU contra $0,006 do equivalente hospedado no GitHub, e um agente de autorreparo na máquina corrige falhas transitórias como timeouts de registry e OOM durante a execução, em vez de falhar o job.